vLLM Kurulumu ve Yönetilen Hosting
Kurulum & Uyumluluk
| Lisans | ⚖️ Apache-2.0 — açık kaynak, kullanımı ücretsiz |
|---|---|
| cPanel ile kolay kurulur mu? | Hayır — GPU'lu sunucu gerekir |
| Sunucu ihtiyacı | Linux GPU sunucu (NVIDIA cc 7.5+, AMD ROCm vb.) |
| Veritabanı | Gerekmez |
| Yerelde (local) çalışır mı? | Evet (Linux + GPU) |
| Barındırma şekli | Sunucuda host gerekir |
Kısaca nasıl kullanılır?
* Bu kurulum/uyumluluk değerlendirmesi, yazılımın teknik yapısına göre e-veri.com tarafından yorumlanmıştır.
Ekran Görüntüleri
Bu yazılım ne işe yarar?
vLLM, büyük dil modellerini (LLM) üretim ortamında hızlı, bellek-verimli ve düşük maliyetle servis etmek için tasarlanmış açık kaynak bir çıkarım (inference) ve sunum motorudur. Berkeley Sky Computing Lab'da geliştirilen proje, bugün 2000'i aşkın katkıcının desteklediği yapay zeka altyapısının fiili standartlarından biri haline gelmiştir.
Neden vLLM?
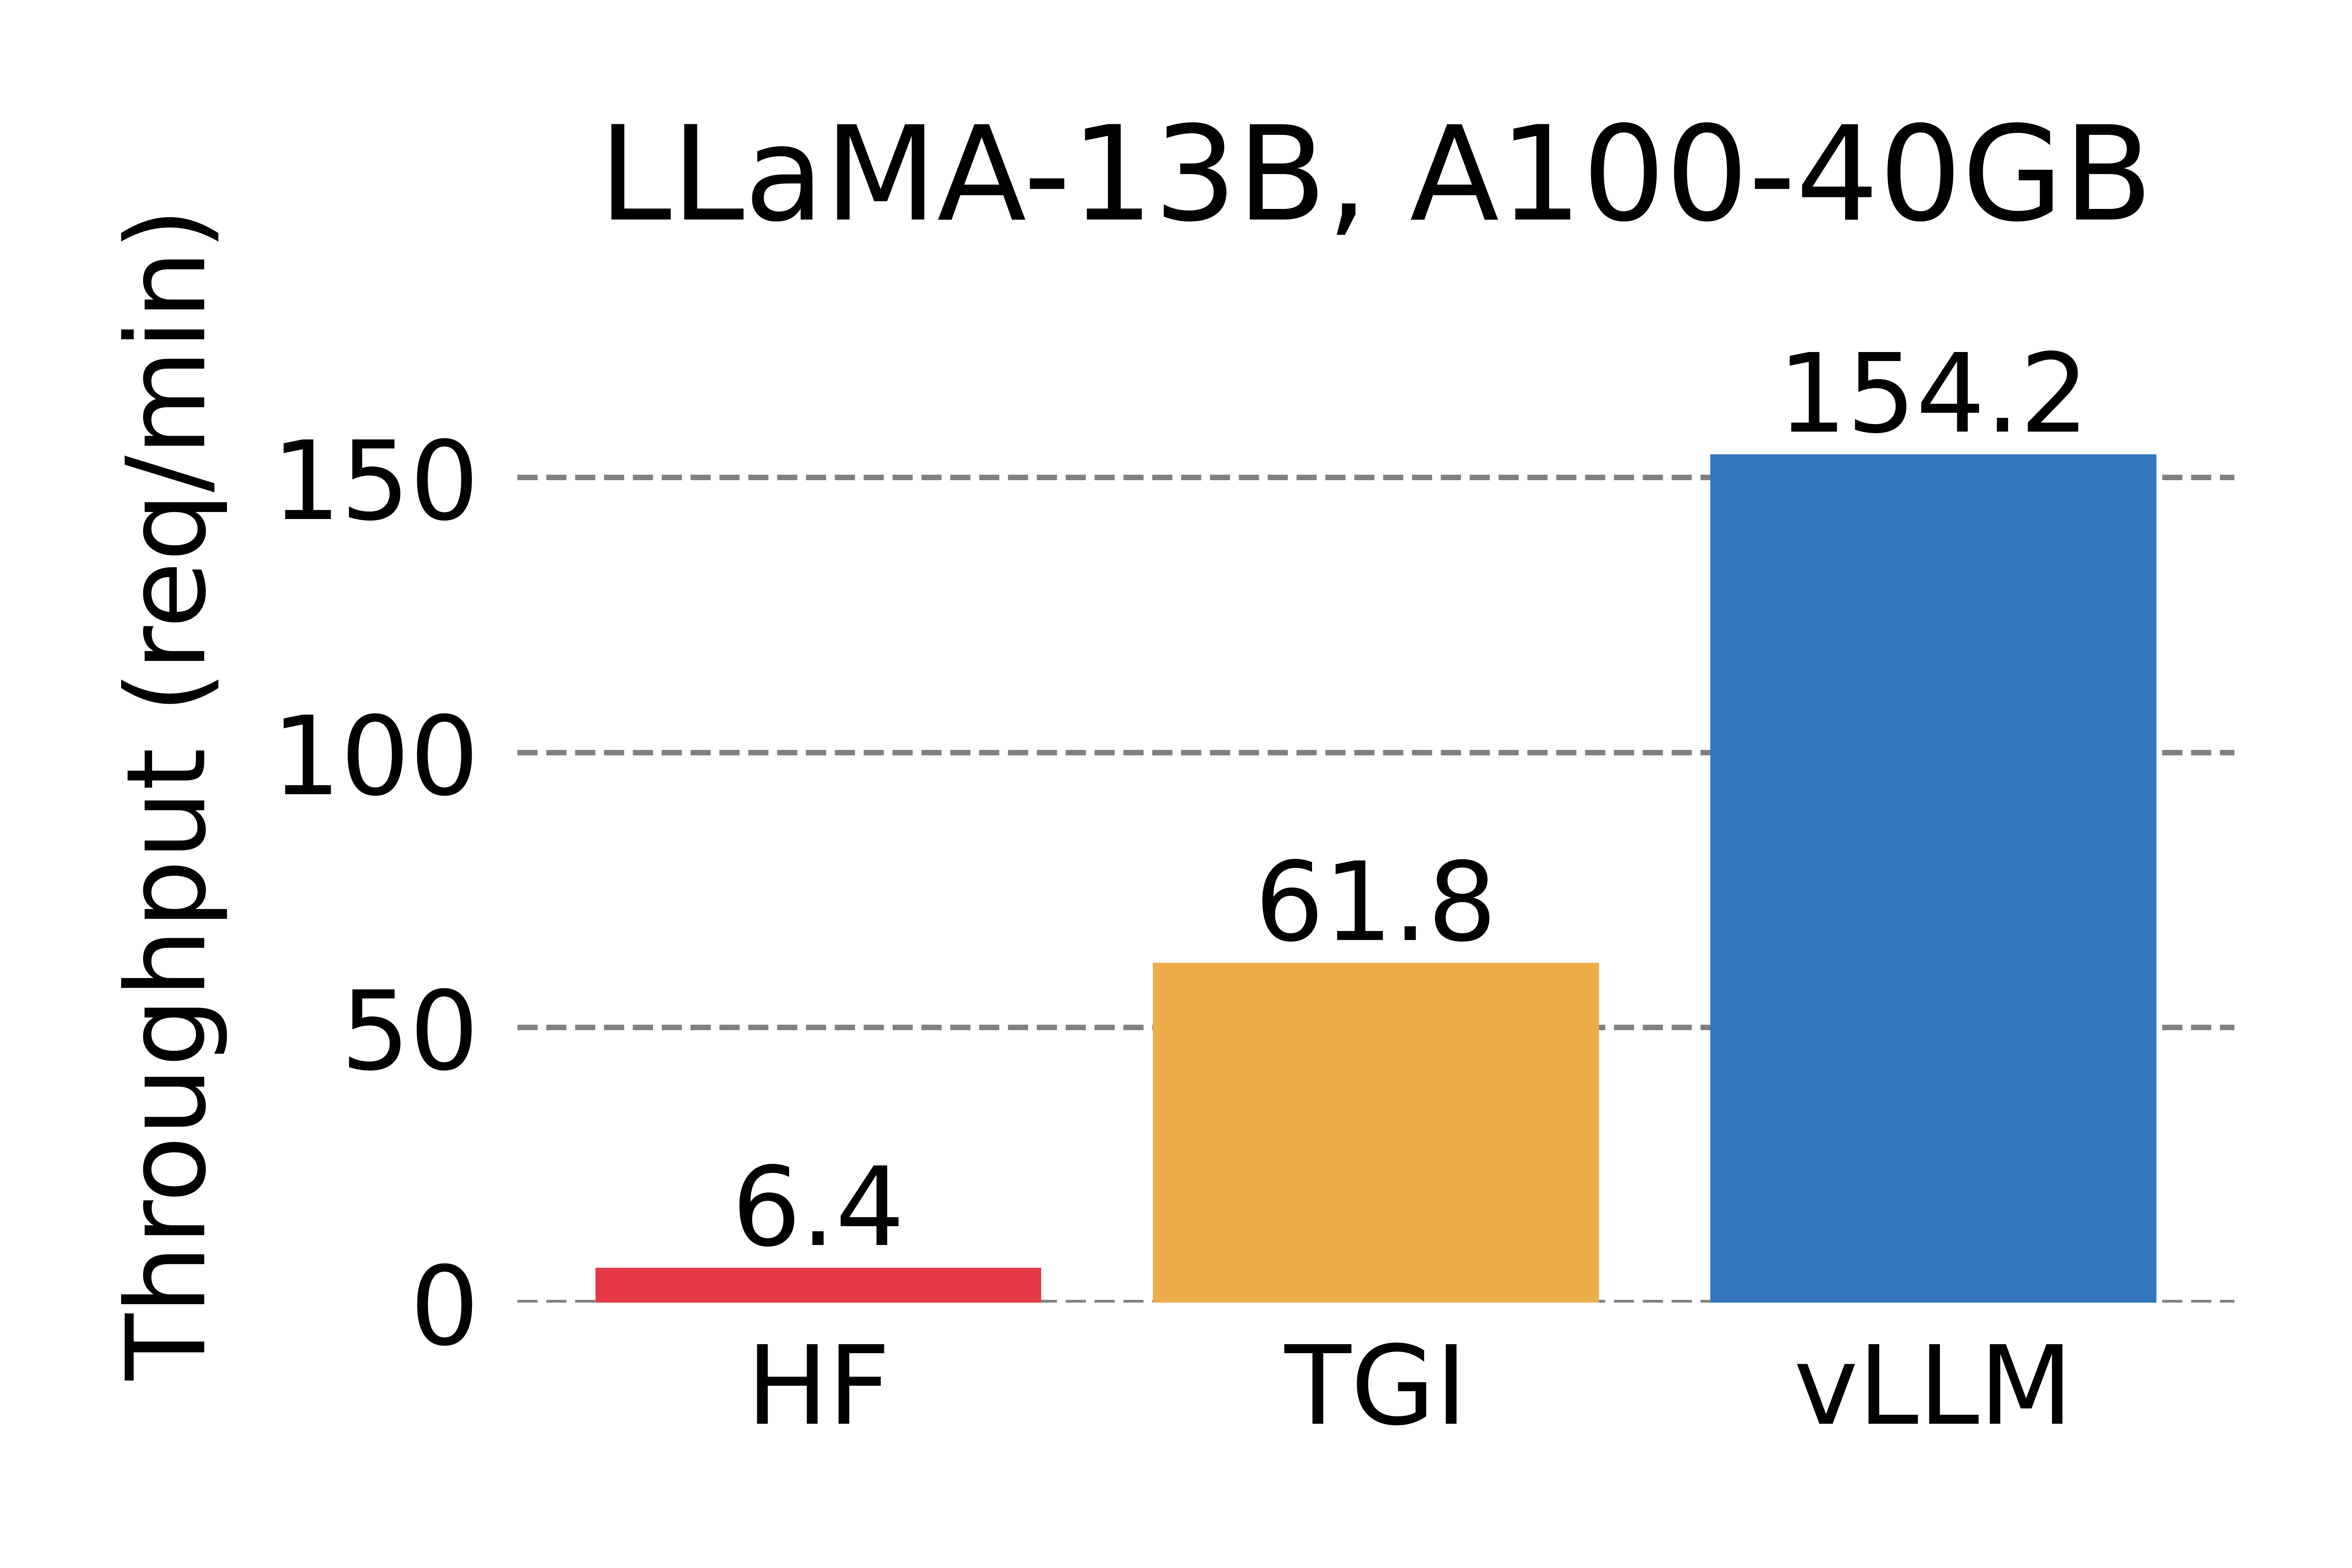
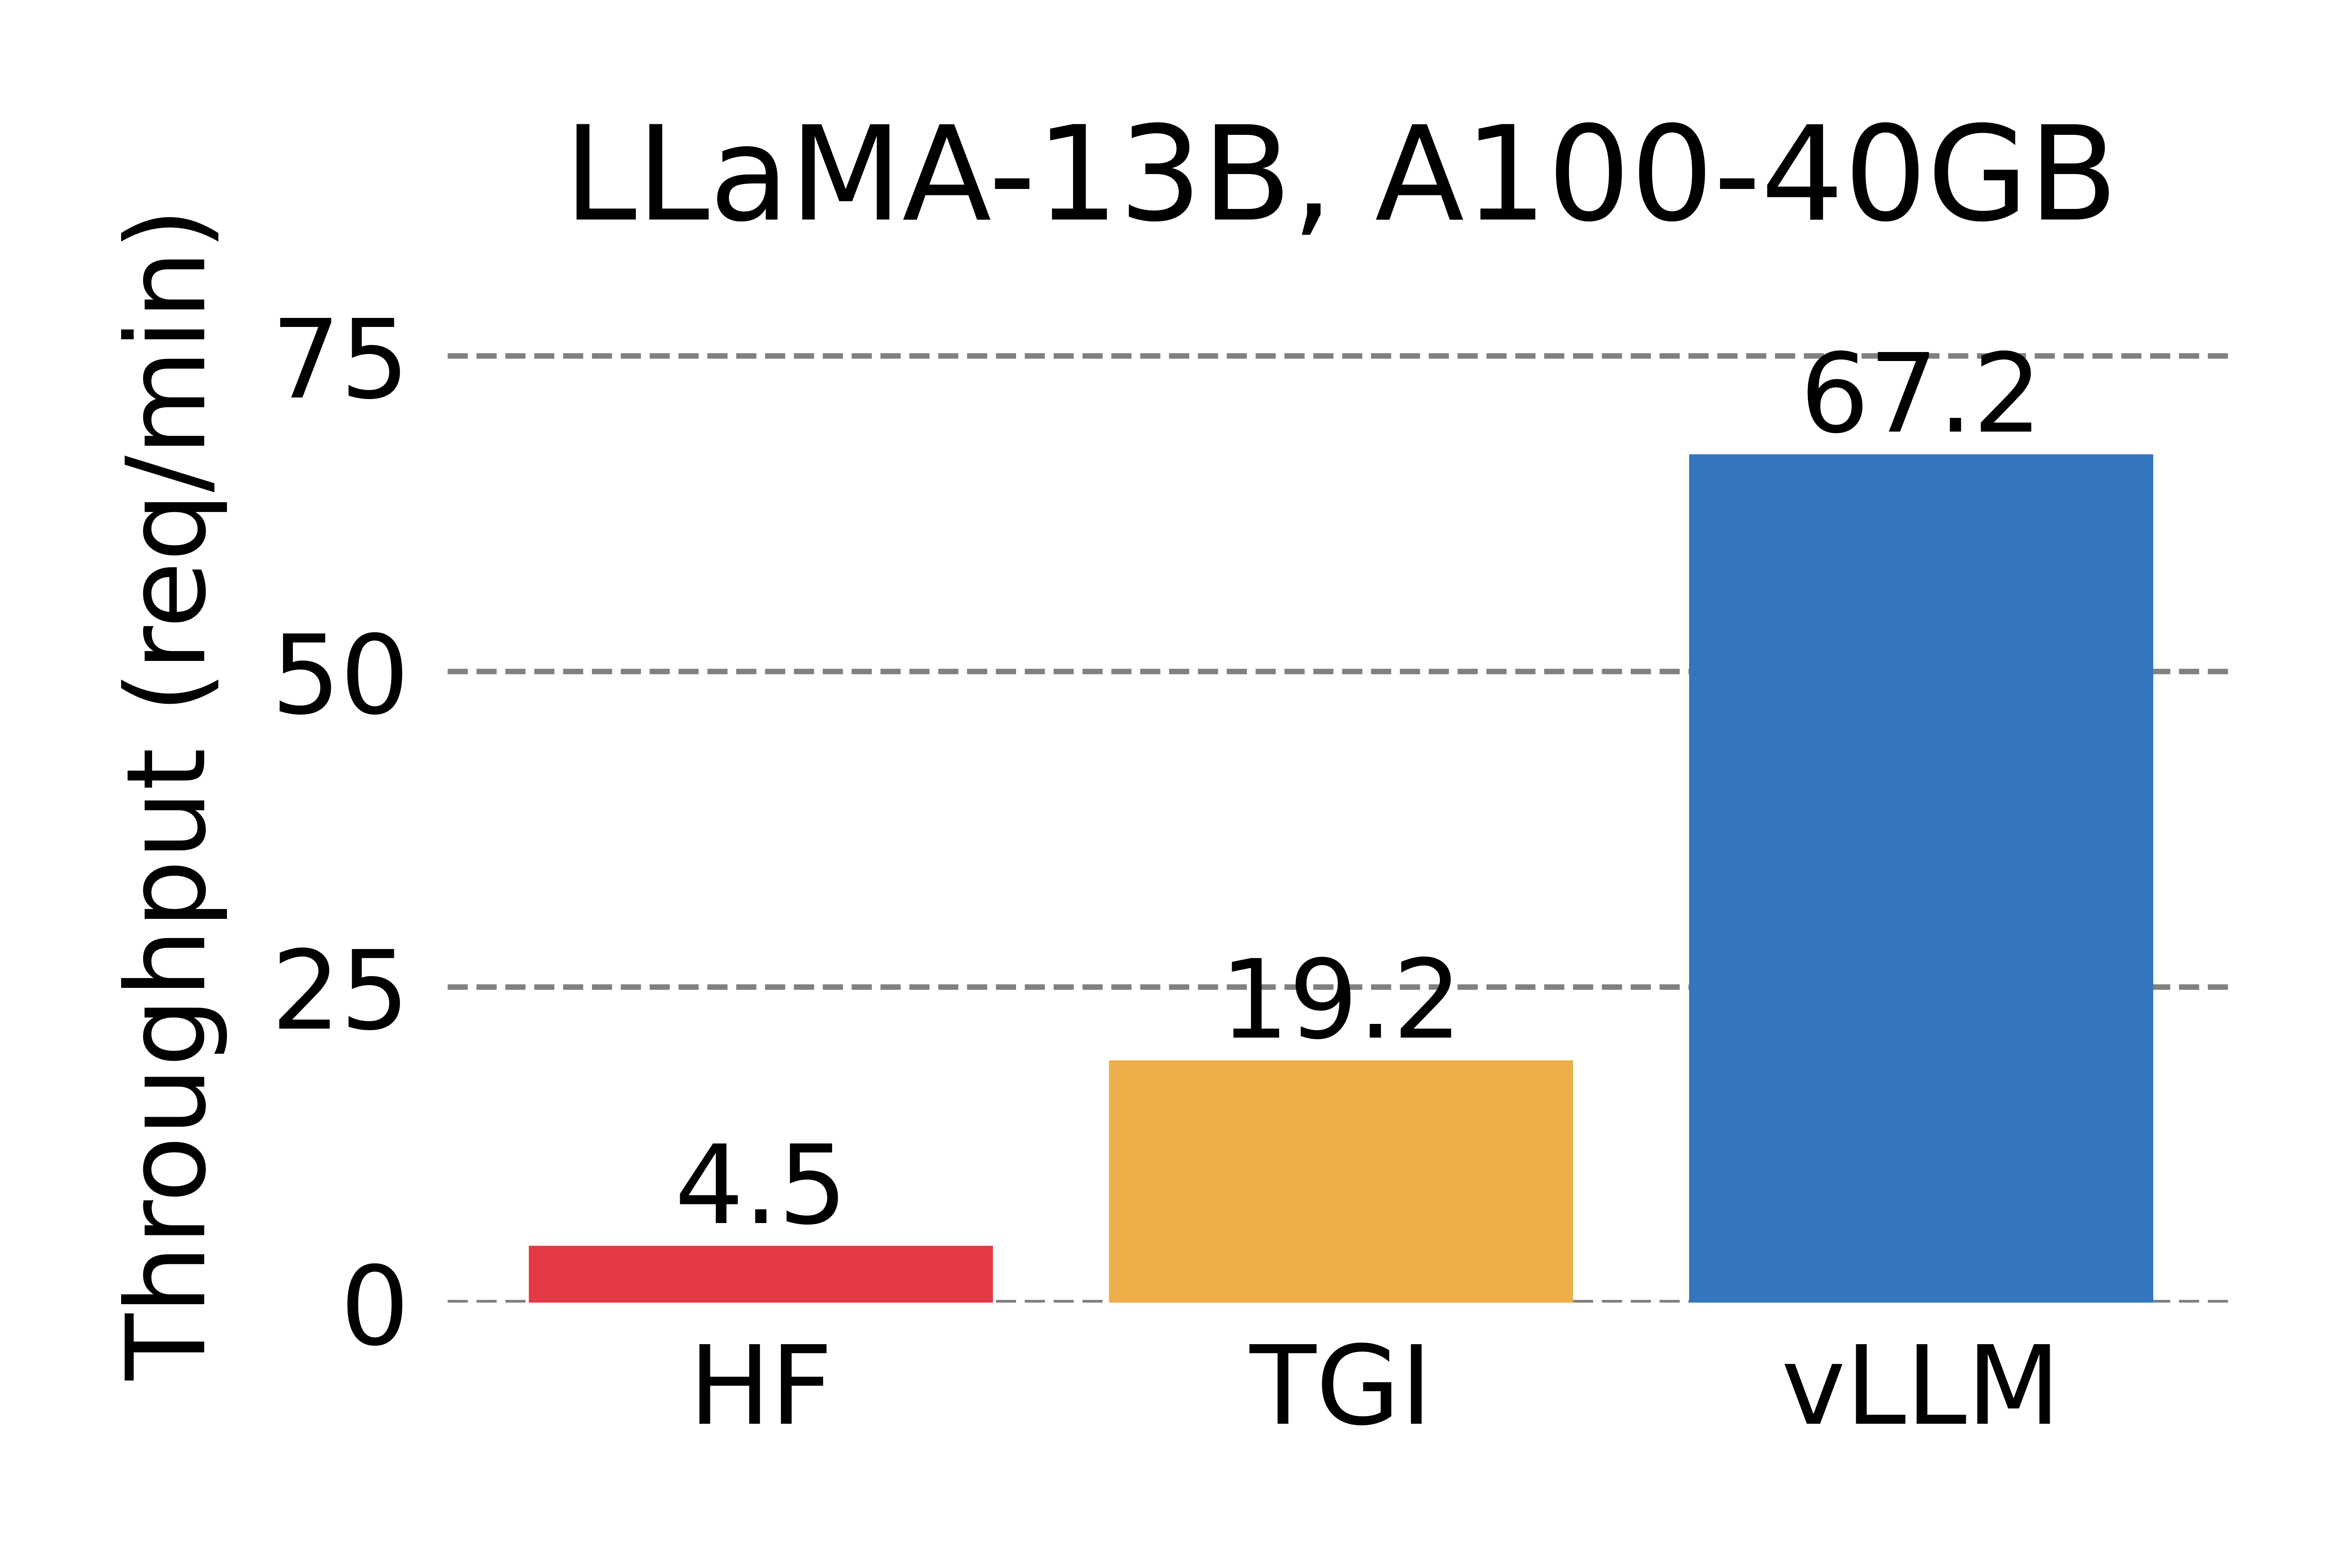
vLLM'in temelinde, GPU belleğini işletim sistemlerindeki sayfalı bellek mantığıyla yöneten PagedAttention teknolojisi yer alır. Bu sayede dikkat (attention) önbelleği israf edilmeden kullanılır ve aynı donanımdan kat kat daha fazla eşzamanlı istek karşılanır. Sürekli batch (continuous batching), önek önbellekleme ve parçalı prefill gibi tekniklerle gelen istekler dinamik olarak gruplanarak GPU sürekli meşgul tutulur; sonuç, geleneksel çözümlere kıyasla belirgin biçimde yüksek verim ve düşük gecikmedir.
Üretime hazır uyumluluk
vLLM, OpenAI uyumlu bir API sunucusu sunar; mevcut OpenAI istemcilerinizi yalnızca uç noktayı değiştirerek kendi altyapınıza yönlendirebilirsiniz. Hugging Face üzerindeki 200'den fazla model mimarisini doğrudan destekler, FP8/INT4/GPTQ/AWQ/GGUF gibi nicemleme (quantization) formatlarıyla maliyeti düşürür ve tensor, pipeline, veri ile uzman paralelliği sayesinde tek GPU'dan çok düğümlü kümelere kadar ölçeklenir.
- PagedAttention ile yüksek bellek verimliliği
- Sürekli batch ve önek önbellekleme ile yüksek istek hacmi
- OpenAI uyumlu REST API ve çoklu LoRA desteği
- NVIDIA, AMD, CPU, TPU ve özel hızlandırıcılar için geniş donanım uyumu
Öne Çıkan Özellikler
Kurumsal Kullanım Senaryoları
- Kendi LLM API'niz: OpenAI uyumlu uç noktayı kendi sunucularınızda çalıştırarak harici sağlayıcıya bağımlı kalmadan ekiplerinize ve uygulamalarınıza dahili bir yapay zeka API'si sunun.
- Maliyet ve gizlilik kontrolü: Token başına dış servis ücreti ödemeden, hassas kurumsal verilerinizi kendi altyapınızdan dışarı çıkarmadan modelleri çalıştırın; veri kontrolü sizde kalsın.
- Yüksek trafikli yapay zeka servisleri: Sohbet botları, RAG tabanlı arama, müşteri destek asistanları ve içerik üretim hizmetlerinde binlerce eşzamanlı isteği tek bir GPU kümesiyle karşılayın.
- Çoklu model ve LoRA dağıtımı: Farklı departmanlar için ince ayarlı LoRA adaptörlerini tek bir servis üzerinde yöneterek donanım kullanımını en üst düzeye çıkarın.
- Toplu çıkarım iş yükleri: Doküman özetleme, sınıflandırma ve gömü (embedding) üretimi gibi yüksek hacimli batch görevlerini ekonomik biçimde işleyin.
Kimler için: vLLM; kendi yapay zeka altyapısını kuran kurumlar, MLOps ve platform mühendisliği ekipleri, açık kaynak LLM'leri üretime taşımak isteyen yazılım firmaları ve veri gizliliği ile maliyet kontrolünü öncelik haline getiren kuruluşlar için uygundur. Dış API maliyetlerini düşürmek, verilerini kendi sunucularında tutmak ve yüksek trafikli yapay zeka servislerini ölçeklendirmek isteyen teknik ekipler için idealdir.
vLLM için e-veri.com hizmetleri
Açık kaynak yazılım ücretsizdir; e-veri.com kurulumunu, yönetilen hosting'ini ve sürekli desteğini kurumsal güvenceyle üstlenir. Aşağıdan size uygun paket için ücretsiz teklif alın.
Kurumsal Kurulum
- Sunucu hazırlığı ve güvenlik
- Kurulum + Türkçe yapılandırma
- Veri/ürün aktarımı
- Eğitim oturumu
Yönetilen Hosting
- Önceden kurulu ortam
- Otomatik yedek
- Güncelleme & izleme
- SSL dahil
Destek & Bakım
- Öncelikli destek
- Düzenli güncelleme
- Yedek doğrulama
- Aylık sağlık raporu
vLLM hakkında sık sorulan sorular
vLLM ücretsiz mi?
vLLM, Apache-2.0 lisanslı açık kaynak bir yazılımdır; yazılımın kendisi için lisans ücreti ödenmez. Maliyet; sunucu, kurulum, bakım ve destek gibi işletme kalemlerinden oluşur. Bazı açık kaynak projelerin ek özellikler sunan ücretli kurumsal sürümleri de bulunabilir.
vLLM cPanel / paylaşımlı hostingte çalışır mı?
Hayır — GPU'lu sunucu gerekir.
vLLM için nasıl bir sunucu gerekir?
Sunucu: Linux GPU sunucu (NVIDIA cc 7.5+, AMD ROCm vb.). Veritabanı: Gerekmez. Kullanıcı sayısına ve kullanım yoğunluğuna göre e-veri.com uygun sunucu boyutunu önerir.
vLLM nasıl kurulur?
vLLM; Python paketi (pip/uv) olarak ya da resmi Docker imajıyla (vllm/vllm-openai, 8000 portunda OpenAI uyumlu API) kurulur. NVIDIA tarafında compute capability 7.5 veya üzeri GPU gerekir (T4, RTX 20 serisi, A100, L4, H100 gibi); AMD ROCm, Intel XPU ve Apple Silicon için ayrı kurulum yolları vardır. Linux ve Python 3.10–3.13 ile çalışır, Windows'u doğrudan desteklemez (WSL önerilir). Yüksek verim için tasarlanmıştır: eşzamanlı istekleri toplu işler (continuous batching, PagedAttention); çok kullanıcılı şirket içi yapay zeka için Ollama'ya göre daha uygundur. Lisans: Apache 2.0. cPanel / paylaşımlı hostingte çalışmaz.
vLLM kendi bilgisayarımda (local) çalışır mı?
Evet (Linux + GPU).
vLLM kurulumunu ve hostingini kim yapabilir?
e-veri.com, vLLM için sunucu hazırlığı, kurulum, Türkçe yapılandırma, yedekleme, güncelleme ve teknik destek hizmeti verir. Verileriniz Türkiye'deki sunucularda ya da kendi altyapınızda tutulabilir. Ücretsiz teklif için sayfadaki formu kullanabilirsiniz.
İlgili yazılar
 Açık Kaynak Lisansları 2026: Şirketler İçin BUSL, AGPL, SSPL ve Ücretsiz Sürüm TuzaklarıKodu açık her yazılım ücretsiz ve sınırsız değil: izin verici, copyleft ve kaynak kodu açık ama kısıtlı lisanslar (BUSL, Elastic, SSPL, FSL), open-core modeli, ücretsiz …
 Kendi Sunucunuzda Yapay Zeka 2026: Ollama + Open WebUI ile Şirket İçi ChatGPTVerileriniz şirket dışına çıkmadan yapay zeka: Ollama ve Open WebUI ile kurulum mimarisi, model boyutları ve lisansları (Qwen3, gpt-oss, Mistral, Gemma, Llama), GPU ve e…
Benzer çözümler ve vLLM alternatifleri
 OpenClawKendi cihazlarınızda çalışan, her mesajlaşma kanalından erişilen kişisel yapay zekâ asistanı.
 ECCYapay zekâ kod araçları için birleşik ajan, beceri ve yapılandırma sistemi.
 Hermes AgentZamanla öğrenen, kalıcı belleğe sahip, çok platformlu açık kaynak yapay zekâ ajanı.
 n8nKod esnekliğini no-code hızında birleştiren, yapay zeka destekli iş akışı otomasyon platformu. Self-hosted ve…
 FirecrawlWeb'i yapay zekâ için temiz veriye dönüştüren açık kaynak tarama ve scraping API'si.
 AutoGPTSürekli çalışan otonom yapay zekâ ajanları oluşturup yöneten açık kaynak platform.